STANLEY TEAM —— 方案研发与工程交付
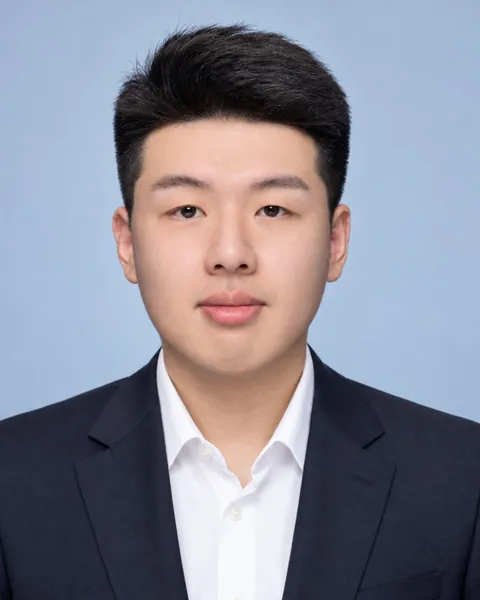
马振源 Miles Ma
FDE 方案设计、算法与数据工程
- 哈尔滨工业大学航天工程本硕 · AI 算法与数据工程专家
- 具备模型优化部署、上亿级数据处理与企业 AI 应用经验
- 深圳大数据研究应用中心 · 人工智能产业应用智库专家
- 模力福地 · AI 产品技术转化与场景实施顾问
简介
哈尔滨工业大学航天工程本硕,具备 AI 算法研发、模型优化与部署及上亿级数据处理经验。技术实践覆盖 Agent、RAG、自动化工作流、私有化模型部署和业务系统集成。
将业务问题拆解为数据需求、知识结构、工具调用与应用流程,连接场景调研、技术选型、原型验证和系统集成;关注评测样本、人工审核与迭代反馈,推动算法和数据能力转化为可使用、可维护的企业应用。
公开分享
2026.10.24 · Stanley Team 杭州闭门分享会 · 02从零起号:X 账号运营与 FDE 实践分享账号定位、选题与互动运营方法,结合 FDE 实践,用内容连接企业需求与商业机会。
撰写的文章
-
INDUSTRY —— 行业方案
安全生产视觉 AI:叠加现有摄像头,实现看见、判断、行动、留证
安全生产视觉 AI 如何落地?本文介绍在不更换前端摄像头的情况下,用边缘识别加中心大模型复核的方式,识别叉车超速、危险区域闯入、未戴安全帽等风险,并通过声光告警、责任人推送和证据链存档形成闭环。
2026.11.04 · 约 1268 字 · 3 分钟 -
FUNDAMENTALS —— 基础概念
什么是大语言模型(LLM)?原理、能力边界与企业用法
大语言模型(LLM)是怎么工作的?本文解释预训练、指令微调、上下文窗口、开源与闭源模型等基本概念,说明大模型擅长和不擅长的事,以及企业如何把大模型安全地用在业务里。
2026.11.04 · 约 1608 字 · 4 分钟 -
FUNDAMENTALS —— 基础概念
什么是 RAG(检索增强生成)?企业知识库问答怎么做才好用
RAG(Retrieval-Augmented Generation,检索增强生成)让大模型先检索企业资料、再基于资料作答。本文讲清 RAG 的原理、企业知识库的完整链路(资料接入、权限、检索、引用、纠错),以及常见的失败原因。
2026.11.04 · 约 1441 字 · 4 分钟 -
FUNDAMENTALS —— 基础概念
大模型为什么会“幻觉”?企业 AI 的关键数字为什么要由代码算
大模型幻觉是指模型生成听起来合理、实际错误的内容。本文解释幻觉产生的原因,以及企业如何用检索引用、拒答机制、规则引擎和人工审批,把幻觉的风险控制在可接受范围内。
2026.11.04 · 约 1291 字 · 3 分钟 -
FDE METHOD —— FDE 方法论
企业 AI PoC 怎么验收?用真实资料建评测集,把指标写进门槛
企业 AI 项目的 PoC(概念验证)应该怎么设计和验收?本文讲清评测集怎么建、常用指标(命中率、引用率、准确率、耗时)怎么定义,以及如何避免“演示很好、上线不行”。
2026.11.04 · 约 1491 字 · 4 分钟
团队战略合作 —— PARTNERSHIPS
- 深圳(福田)海联大模型和算法赋能服务中心
- 企业 AI 转型与场景落地战略合作伙伴
- 深圳市大数据研究与应用协会人工智能专委会
- 企业 AI 转型与组织赋能战略合作单位